Son propre moteur
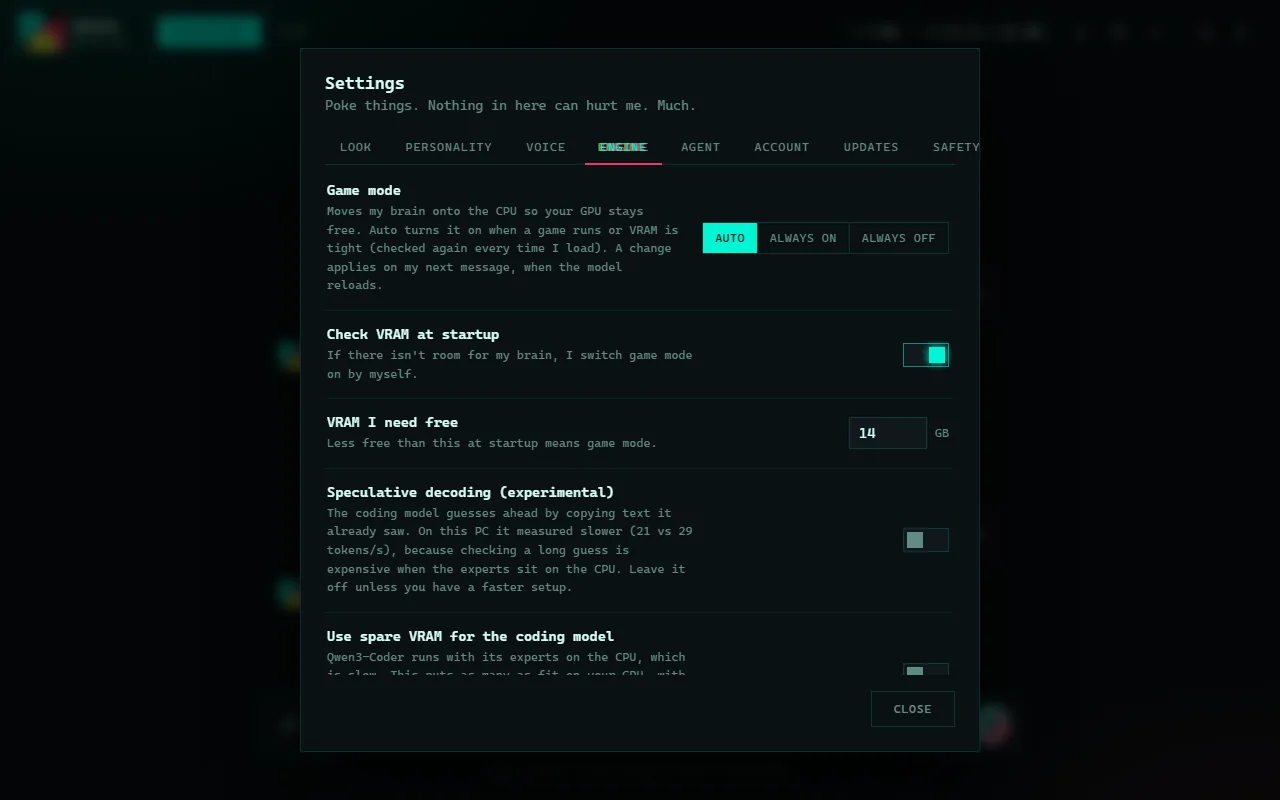
Nova exécute llama.cpp comme processus d'arrière-plan caché, seulement tant qu'elle est ouverte. Un seul modèle est chargé à la fois, donc chacun a tout le GPU, et les modèles inactifs se déchargent après cinq minutes.
Les modèles se chargent d'une façon qui limite un modèle chargé à environ 1,7 Go de RAM au lieu d'environ 9 Go, le reste étant dans la mémoire vidéo. Fermer Nova arrête tout, et Windows arrête le moteur même si Nova plante.